Für die ersten Schritte mit unserer dokumentenbasierten KI-Lösung haben wir auf große US-Modelle gesetzt. Doch mit Blick auf die europäische KI-Souveränität stellte sich die Frage: Braucht es für anspruchsvolle Unternehmensanwendungen tatsächlich ein US-Modell? Um das herauszufinden, haben wir Mistral Large 3 und GPT-5.1 im produktiven Einsatz unserer eigenen RAG-Anwendung (Retrieval-Augmented Generation) verglichen.
So funktioniert die RAG-Lösung von PASS
Die KI-basierte Dokumentenanalyse von PASS kommt überall dort zum Einsatz, wo große Mengen unterschiedlicher Dokumente gelesen, verknüpft und nach vorgegebenen Kriterien bewertet werden müssen. Falls erforderlich, unterstützt die Lösung auch bei der Ableitung von Kriterien, beispielsweise aus EU-Verordnungen.
Die Funktionsweise orientiert sich am RAG-Prinzip:
1. Datenextraktion und Dokumentenverarbeitung (Retrieval)
Die zu analysierenden Dokumente werden hochgeladen und der enthaltene Text wird extrahiert.
2. Anreicherung durch fachspezifische Richtlinien und Prompts (Augmentation)
Der extrahierte Text wird mit strukturierten, domänenspezifischen Hintergrundinformationen angereichert (augmentiert):
- Richtlinien enthalten domänen- und unternehmensspezifische Kriterien in natürlicher Sprache.
- System und User Prompts beschreiben den Kontext und enthalten Handlungsanweisungen, die Abfragelogik sowie Vorgaben für die Ausgabe.
3. Kontextbasierte Generierung (Generation)
Das ausgewählte Large Language Model (LLM) verarbeitet den kombinierten Input aus den Schritten 1 und 2 und generiert daraus folgende Ergebnisse:
- Eine prägnante Zusammenfassung der analysierten Dokumente.
- Strukturierte Schlüsselinformationen aus den Dokumenten.
- Eine detaillierte Kriterienbewertung mit quantitativen Scores und qualitativen Begründungen.
- Verbesserungsvorschläge für die Scores inklusive konkreter Formulierungsvorschläge.
4. Audit-Schleife als RAG-Qualitätssicherung (LLM-as-a-Judge)
Eine Besonderheit der PASS-Software ist die integrierte Audit-Funktion nach dem Prinzip eines Peer Reviews, auch LLM-as-a-Judge genannt. Dabei prüft ein zweites, unabhängiges „Gutachter“-Modell die Erstbewertung. Es erhält den extrahierten Dokumententext, die Richtlinien sowie die Ergebnisse der Erstbewertung. Anschließend gleicht es jede Behauptung direkt mit dem Dokumententext ab, korrigiert Fehler, ergänzt wörtliche Textbelege (Zitate/Beweise) und berechnet einen Konfidenzwert. Dies minimiert das Risiko von Halluzinationen und sichert die Validität der Ergebnisse.
Die Lösung läuft in den deutschen Rechenzentren von PASS. Lediglich für die Schritte 3 und 4 werden Daten an das ausgewählte LLM übermittelt.
Bereits umgesetzte Anwendungsfälle
Einer der ersten Einsatzbereiche war die Analyse komplexer Kundenverträge im PASS-Vertragscontrolling. Eine vorjuristische Vertragsprüfung dauert heute etwa ein bis drei Minuten. Danach liegen Schlüsselinformationen, Risiken und Verbesserungsvorschläge inklusive konkreter Formulierungen zur Übernahme in den Vertragstext vor. Nach weiteren fünf Minuten Laufzeit erhalten wir ein Gutachten der Prüfung mit Verweisen und Empfehlungen, das von einem anderen LLM erstellt wurde. Seit der Inbetriebnahme wurden mit der Lösung bereits über 150 Verträge geprüft.
Inzwischen setzen wir die Lösung auch ein, um unsere ISMS-Leitlinien auf Konformität mit dem Internen Kontrollsystem zu prüfen. Ein weiterer Anwendungsfall sind Qualitätsberichte. Hier werden regelmäßig Fehlerkennzahlen aus dem Ticketsystem und Ergebnisse der statischen Codeanalyse anhand festgelegter Kriterien und der Vorgaben der ISO 25010 ausgewertet. Im Pilotbetrieb befindet sich der Abgleich von Projektausschreibungen mit den Skill-Profilen unserer IT-Berater.
Warum PASS auf verschiedene LLMs setzt
Angesichts der Vielfalt und Weiterentwicklung von LLMs haben wir unsere Software von Grund auf so konzipiert, dass das für die kontextbasierte Generierung in Schritt 3 verwendete Modell frei gewählt werden kann. Voraussetzung sind die Verfügbarkeit einer entsprechenden API und die erforderlichen Nutzungsvereinbarungen. So lässt sich derselbe Satz an Dokumenten nacheinander mit verschiedenen Modellen oder unterschiedlichen Temperaturwerten (siehe Infobox) analysieren. Die Ergebnisse können anschließend direkt miteinander verglichen werden. Dies ist unabhängig von der Audit-Schleife in Schritt 4 möglich.
Diese Fähigkeit ermöglicht es uns, verschiedene LLMs zu testen und Parameter und Anreicherungen gezielt auf Validität, Effizienz und Datenschutz abzustimmen. Die Multi-LLM-Fähigkeit reduziert zudem Risiken, die durch die Abhängigkeit von Technologien fremder Großmächte entstehen.
Wie die Temperatur die Antworten eines LLM beeinflusst
Bei einer Temperatur von 0 folgt das Modell strikt dem mathematisch nächsten Pfad. Bei hochkomplexen Begründungen, juristischen Prüfungen oder vielschichtigen Kriterienbewertungen kann sich das Modell dadurch in gedankliche „Sackgassen“ manövrieren. Alternative, logisch elegantere Verknüpfungspfade bleiben unberücksichtigt, wenn der erste Begriff auf einem solchen Pfad beispielsweise nur die zweithöchste Wahrscheinlichkeit hat. Erhöht man die Temperatur auf etwa 0,1 bis 0,2, was auch als „leichtes Temperatur-Rauschen“ bezeichnet wird, erhält das Modell den nötigen Spielraum, um auch Begriffe auszuwählen, die bspw. erst an zweiter oder dritter Stelle der Wahrscheinlichkeit liegen. Dadurch können unterschiedliche Argumentationsstränge flüssiger und logisch stimmiger miteinander verwoben werden. Bei hohen Temperaturen (ab 0,7) werden auch Wörter und Zusammenhänge wählbar, deren Wahrscheinlichkeit sehr niedrig ist. Hier beginnt das Modell mitunter zu „fantasieren“ und Fakten quasi zu erfinden (Halluzination).
Bei allen oben genannten Anwendungsfällen hat sich das leichte Temperatur-Rauschen, d.h. ein Wert zwischen 0,1 und 0,2, als optimal erwiesen.
Die Bedeutung des Modell-basierten Wissens
Bei den oben genannten Anwendungsfällen ist das Modell-basierte Wissen entscheidend für die Interpretation der Benutzeranfrage und der zu analysierenden Dokumente. Es ermöglicht dem LLM, verteilte Informationen miteinander zu verknüpfen, Schlussfolgerungen zu ziehen (Reasoning, siehe Kasten), rohe Daten in eine grammatikalisch korrekte Antwort einzubetten und die Ausgabe im gewünschten Format zu generieren.
Was bedeutet Reasoning bei KI-Modellen?
Die Frontier-KI GPT-5.1 verfügt über ein tiefes, enzyklopädisches Allgemeinwissen und ein ausgeprägtes Verständnis komplexer, fachübergreifender Zusammenhänge. Das zeigt sich besonders, wenn man im Chat mit der KI zu unterschiedlichen Themen kommuniziert. Für domänenspezifische Anwendungsfälle wie die oben genannten ist ein solch breites Wissen jedoch nicht zwingend erforderlich.
Das Modell von Mistral verfügt vermutlich über etwa halb so viele Parameter wie GPT-5.1. Diese sind jedoch auf verschiedene Expertennetzwerke verteilt. Diese Architektur wird als Mixture-of-Experts (MoE) bezeichnet. Ein Router, also ein Steuerungsnetzwerk, leitet den Text an die jeweils relevanten Experten-Teilnetzwerke weiter. Vereinfacht lässt sich das Prinzip mit einem hochspezialisierten Expertenteam vergleichen, bei dem für jede Aufgabe nur die am besten geeigneten Mitarbeiter aktiviert werden.
Augmentierung des Modell-basierten Wissens
Für die oben genannten Anwendungsfälle sind ein breites Allgemeinwissen, die Fähigkeit zu logischen Schlussfolgerungen und ein gutes Sprachverständnis wichtig. Hinzu kommen domänen- und unternehmensspezifische Vorgaben sowie Handlungsanweisungen. Mit diesen Informationen wird das Modell-basierte Wissen des LLM in Schritt 2 des RAG-Prozesses angereichert.
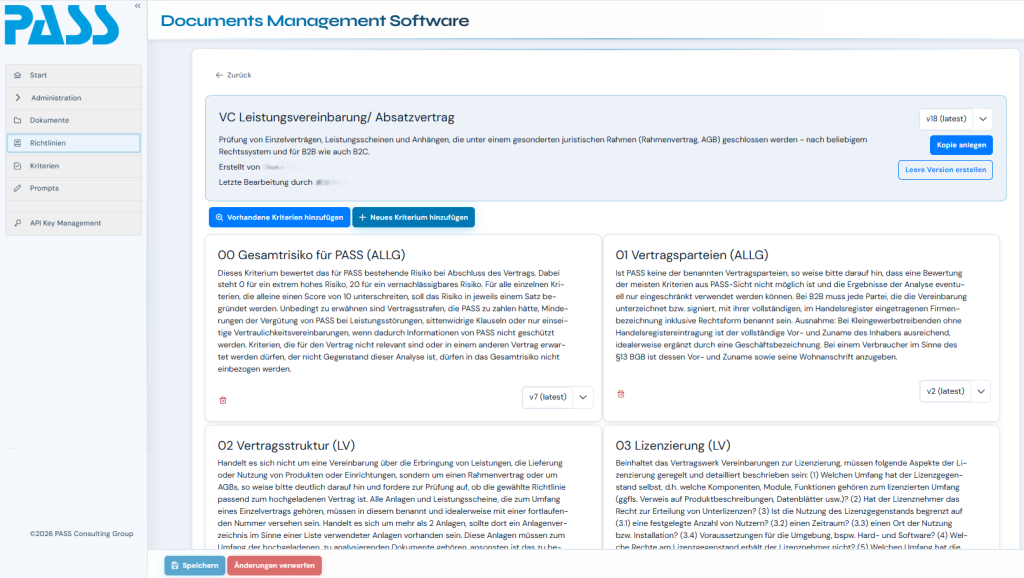
Bei der Anwendung im Vertragscontrolling legen wir mit der PASS-Lösung flexibel fest, welche Aspekte uns bei einer Vertragsprüfung wichtig sind und wie wir diese priorisieren. Dafür nutzen wir Richtlinien für verschiedene Vertragstypen, denen vordefinierte Kriterien zugeordnet sind. Die Kriterien werden in natürlicher Sprache beschrieben und bauen auf dem Sprachverständnis und Wissen des verwendeten LLM auf.
Sowohl bei GPT-5.1 als auch bei Mistral Large 3 kann man davon ausgehen, dass die KI beispielsweise die vertragliche Relevanz von DORA und die Bedeutung kritischer oder wichtiger Funktionen versteht. Gleiches gilt für die Unterschiede zwischen B2B und B2C oder die Implikationen von Common Law gegenüber einem EU-Rechtssystem.
Prompt Engineering
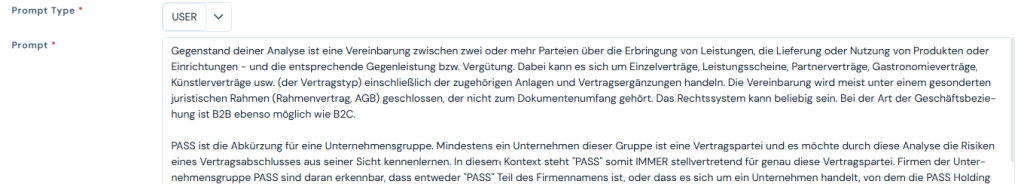
Während Richtlinien und Kriterien das Modell um domänen- und unternehmensspezifische Informationen anreichern, geben Prompts Verhaltens- und Handlungsanweisungen vor. Strukturierte, detaillierte Prompts gelten als Best Practice für auditsicheres, reproduzierbares Software-Engineering im Kontext von KI-Anwendungen. Dabei setzt ein System Prompt die Leitplanken für den jeweiligen Anwendungsfall. Er definiert, welche Rolle die KI zur Erledigung der Aufgaben einnimmt, gibt Regeln vor und legt verbindliche Einschränkungen fest.
Ein User Prompt geht auf den spezifischen Vertragstyp ein und beschreibt das gewünschte Vorgehen. Idealerweise definiert er zunächst wichtige Begriffe und Zusammenhänge, die das LLM nicht aus seinem Modell-basierten Wissen ableiten kann, aber zum Verständnis der Kriterien benötigt. Anschließend wird die Aufgabe in einzelne Schritte zerlegt. Für jeden Ausgabe-Tab (Schritt 3 im RAG-Prozess) werden Inhalt und Gliederung beschrieben.
Mistral vs. OpenAI: Unterschiede in der RAG-Anwendung
Entscheidend für die Qualität des Analyseergebnisses ist eine sorgfältige und detaillierte Beschreibung der Kriterien, mit denen das Modell-basierte Wissen angereichert wird. Ohne diese domänen- und unternehmensspezifischen Vorgaben basieren die Bewertungen jeder KI nur auf dem Allgemeinwissen zum jeweiligen Stand ihrer Trainingsdaten.
Einen deutlichen Unterschied konnten wir bei der Ausformulierung der Prompts feststellen. Die Frontier-KI GPT-5.1 kommt auch mit sehr knapp formulierten User Prompts zurecht. Fehlende Definitionen und Erklärungen kann das LLM meist korrekt interpretieren und selbst eine nur rudimentäre Aufgabenbeschreibung sinnvoll vervollständigen. Ein derart minimalistisch formulierter User Prompt bereitet Mistral deutlich größere Probleme. Mistral liegt in seinen Annahmen häufiger daneben.
Anders sieht es bei einer sorgfältig durchdachten und spezifizierten RAG-Anwendung aus. Wenn menschliche Fachexperten die Richtlinien, Kriterien und Prompts ausformulieren und regelmäßig prüfen, optimieren und ergänzen, gibt es bei der Ergebnisqualität fast keine Unterschiede mehr zwischen GPT-5.1 und Mistral Large 3.
Auf die Spezifikation und regelmäßige Qualitätssicherung eines solchen Systems kann jedoch nicht verzichtet werden. Gerade bei der Vertragsanalyse ist die eigene Rechtsauffassung stark individuell bzw. unternehmensspezifisch. Das gilt entsprechend auch für die Priorisierung der einzelnen Bewertungskriterien. Gesetze sind kein deterministisches Regelwerk.
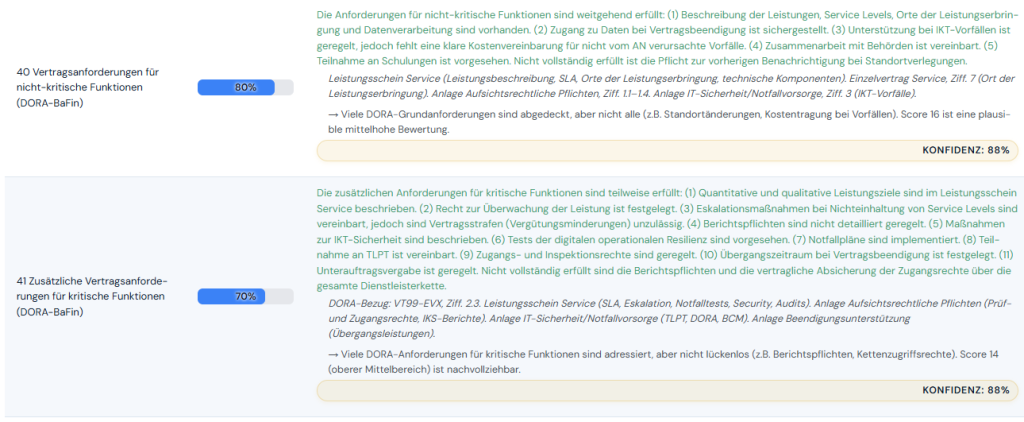
Qualitativ sind beide KIs bei guter Augmentierung gleichwertig. Das ist nicht nur unsere menschliche Einschätzung. Mit der PASS-Lösung kann das Ergebnis der Erstprüfung zusätzlich einem Peer Review durch ein anderes Modell unterzogen werden (LLM-as-a-Judge). In nahezu allen Fällen bestätigt GPT-5.1 dabei die Ergebnisse der von Mistral durchgeführten Erstprüfung, statt sie zu korrigieren. Das folgende Bild zeigt das Ergebnis eines solchen Peer Reviews. Grün dargestellt ist jeweils die von Mistral formulierte und von GPT-5.1 bestätigte Erläuterung zum Score. Darunter stehen in kursiver Schrift die Quellenangaben. Hinter dem Pfeil folgen die Anmerkung des Gutachters GPT-5.1 zum Score und der von ihm geschätzte Konfidenzwert.
Mistral vs. OpenAI: Wer überzeugt im Praxistest?
Was bedeutet das nun für die europäische KI-Souveränität? Betrachten wir Mistral Large 3 und GPT-5.1 anhand der Kriterien, die für den produktiven Einsatz in europäischen Unternehmen relevant sind.
- Qualität der Analyseergebnisse
Hier liegen beide LLMs gleichauf: Spielstand 1:1.
- Kosten
Die Kosten für GPT-5.1 sind sehr hoch. Bei Mistral Large 3 betragen die Gesamtkosten für eine produktive RAG-Pipeline mit hoher Abfragedichte dagegen nur einen Bruchteil davon (ca. 15 % bis 30 %). Durch Prompt Caching können sie beispielsweise noch weiter reduziert werden. Spielstand: 2:1 für Mistral.
- Laufzeit
GPT-5.1 punktet mit einer exzellenten Token-Generierung. Bei Anfragen aus Europa kommen jedoch transkontinentale Netzwerk-Latenzen sowie Denkzeiten durch Adaptive Reasoning hinzu. Mistral profitiert dagegen von Serverstandorten in der EU, beispielsweise in Frankfurt oder Paris. Das reduziert sowohl die Round-Trip-Time (RTT) als auch die Zeit zwischen dem Absenden eines Prompts und dem ersten Zeichen der Antwort (Time-to-First-Token, TTFT). Auch die MoE-Architektur von Mistral wirkt sich durch das dynamische Routing positiv auf Latenz und Durchsatz aus. In der Praxis können wir bestätigen, dass Mistral für qualitativ gleichwertige Analyseergebnisse etwa zwei Drittel der Laufzeit von GPT-5.1 benötigt. Daher 3:1 für Mistral.
- Ökologischer Impact
Die Klimabilanz einer RAG-Anfrage wird stark vom Standort des Rechenzentrums bestimmt. Eine in Frankreich (z. B. Paris) gehostete Mistral-Instanz profitiert vom CO₂-armen französischen Stromnetz mit einem hohen Anteil an Nuklear- und Wasserkraft. GPT-5.1 läuft dagegen oft in US-Datenzentren mit einem, je nach Standort, stärker fossil geprägten Energiemix. Der Treibhausgasausstoß je generierter Antwort liegt bei einer in Frankreich oder Deutschland gehosteten Mistral-Instanz im Schnitt deutlich unter dem von US-gehosteten Hyperscaler-Instanzen. Deshalb 4:1 für Mistral.
- Verfügbarkeit
Potenzielle Handelsrestriktionen oder Datenübermittlungsstopps zwischen den USA und der EU stellen für die Verfügbarkeit von GPT-5.1 ein Risiko dar. Mistral dagegen bietet verlässliche Hochverfügbarkeit mit B2B-SLAs bei europäischen Providern. Daher 5:1 für Mistral.
- Datenschutz
Der US CLOUD Act erlaubt US-Behörden unter bestimmten Bedingungen den Zugriff auf Daten, die US-Unternehmen anvertraut wurden – auch wenn die Server in Europa stehen. Das betrifft GPT-5.1. Mistral AI ist ein französisches Unternehmen und ermöglicht Nutzungsvereinbarungen mit vollständiger Datenresidenz in der EU sowie eine DSGVO-konforme Vereinbarung zur Auftragsverarbeitung. Damit lassen sich auch die Auflagen des Europäischen AI Act besser erfüllen. Schlussstand: 6:1 für Mistral.
Unser Praxistest zeigt: Europäische KI-Souveränität ist heute auch bei anspruchsvollen Unternehmensanwendungen eine realistische Option. Unternehmen müssen sich bei der Wahl eines LLM nicht zwangsläufig zwischen Leistungsfähigkeit und europäischer Technologie entscheiden. Wenn europäische Modelle bei der Ergebnisqualität mithalten können, werden Faktoren wie Kosten, Datenschutz, Verfügbarkeit und die Abhängigkeit von außereuropäischen Anbietern zu relevanten Entscheidungskriterien. Das schafft die Möglichkeit, technologische Abhängigkeiten zu reduzieren, ohne bei der Qualität der Anwendung Abstriche machen zu müssen.
Bildquellen: Gemini & PASS Consulting Group